寫作 · Enterprise AI ·
越來越少調 Prompt 之後:Context Engineering
模型會一直換,企業真正能累積下來的,是自己的 know-how。
文/Eason Kuo · Senior Vice President,國泰健康管理
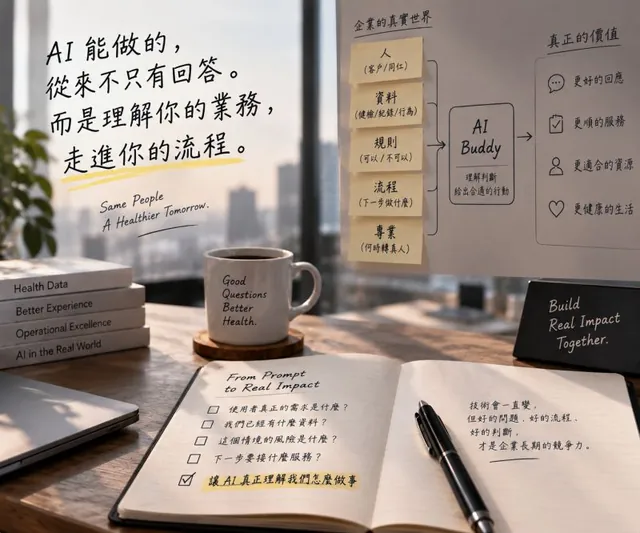
最近 Enterprise AI 越來越少在調 Prompt。
不是 Prompt 不重要,而是做得越深,越會發現真正難的都在後面。
表面上,只是多幾個 Agent
最近我們在做 AI 的新場景,從飲食、健檢後照護,到增肌減脂、熟齡健康。
表面上看起來只是多幾個 Agent、多一些知識。一開始我也是這樣想的:每個場景準備好對應的知識內容,寫好 Prompt,調一調語氣,應該就差不多了。
但真的要上線服務客戶,問題很快就變成:
- AI 現在應該知道哪些資料?
- 哪些情況可以回答,哪些要停?
- 什麼時候要轉真人?
- 回答完之後,下一步要接什麼服務?
這四個問題,沒有一個能靠把 Prompt 寫得更漂亮解決。
模型很會回答,但不認識這個人
舉個例子。使用者問:「我最近很容易累,要補充什麼?」
模型其實很容易回答。它可以列出睡眠、飲食、壓力、運動等常見因素,再給一些一般性的建議,語氣溫和、內容完整。
真正難的是,它知不知道這個人的健檢結果、過去紀錄、風險狀況,以及公司本身的服務規則。
同一句「很容易累」,背後的情境可能差很多。一般的生活建議,對某些人很合適;對另一些人來說,更重要的可能是提醒他回頭看自己的健檢追蹤、或是建議他找專業醫療人員討論。模型如果不知道這些脈絡,再流暢的回答,也可能不是這個人現在最需要的。
回答得好,和回答得對,是兩件事。
Context Engineering 不是塞更多資料
做到這裡,我才越來越理解 Context Engineering 的價值。
我原本以為,答案就是給 AI 更多資料:知識庫再大一點、資料再多接幾個。後來發現不是這樣。資料塞太多,AI 反而抓不到重點;而且有些資料,根本不該在那個時間點被它看到。
Context Engineering 真正在做的,是把原本散落在人腦、SOP、系統與流程裡的經驗,整理成 AI 在對的時間可以使用的脈絡。
拆開來看,大概是幾件事:
- 對的資料:這次對話需要知道這個人的哪些資訊,哪些是不需要、也不應該讀的。
- 對的規則:公司的服務規範、什麼可以說、什麼一定不能說。
- 對的邊界:哪些情境要停下來,哪些要轉給真人。
- 對的下一步:回答完之後,要接到哪個服務或提醒。
這些東西,很多原本只存在資深同仁的腦袋裡。他們知道遇到什麼樣的客戶要多問一句,知道哪種問題要小心回應。把這些經驗變成 AI 可以用的脈絡,才是最花時間、也最有價值的工作。
問題從「用哪個 Model」變成「懂不懂你們」
所以現在一個 AI 專案,已經不太先問:「你們用哪個 Model?」
更重要的是:
這個 AI 到底懂不懂你們公司怎麼做事?
模型選擇當然有影響,但它的差距正在縮小,而且每隔幾個月就會換一輪。今天選的最強模型,明年可能就不是了。
但企業真正能累積下來的,是自己的 know-how:服務流程、風險判斷、客戶脈絡、處理例外的方法。這些東西整理好了,換模型的時候可以帶著走;沒有整理,換再強的模型也只是從頭再來。
最後
模型會一直換,但企業真正能累積下來的,是自己的 know-how。
這可能才是 Enterprise AI 真正開始拉開差距的地方。不是誰先用上最新的模型,而是誰先把自己怎麼做事,整理成 AI 讀得懂的樣子。
至於 Prompt?還是要寫,只是它越來越像整套系統裡最小的一塊。